Llama là bước đột phá mang tính bản lề của tập đoàn Meta trong lĩnh vực trí tuệ nhân tạo, mở ra khả năng tự triển khai (self-host) các mô hình ngôn ngữ lớn trên hạ tầng riêng biệt cho cộng đồng doanh nghiệp và nghiên cứu. Khác với các hệ sinh thái đóng độc quyền, dòng mô hình này cung cấp trọng số mở (open weights), hỗ trợ giải quyết triệt để bài toán bảo mật dữ liệu nội bộ và tối ưu hóa chi phí vận hành. Bài viết dưới đây sẽ phân tích toàn diện từ cấu trúc vi kiến trúc, phương pháp tinh chỉnh RLHF cho đến yêu cầu phần cứng thực tế nhằm giúp bạn khai thác triệt để tiềm năng của hệ sinh thái công nghệ này.
Llama là gì và những bước chuyển mình công nghệ từ Meta
Llama (viết tắt của Large Language Model Meta AI) là dòng mô hình ngôn ngữ lớn đa nhiệm được phát triển bởi nhóm nghiên cứu FAIR (Fundamental AI Research) và GenAI thuộc Meta. Khác với các hệ thống đóng, Llama cho phép giới nghiên cứu và doanh nghiệp tải về bộ trọng số để tự nghiên cứu, tùy biến và self-host trên cụm máy chủ nội bộ mà không bị phụ thuộc vào API của bên thứ ba.
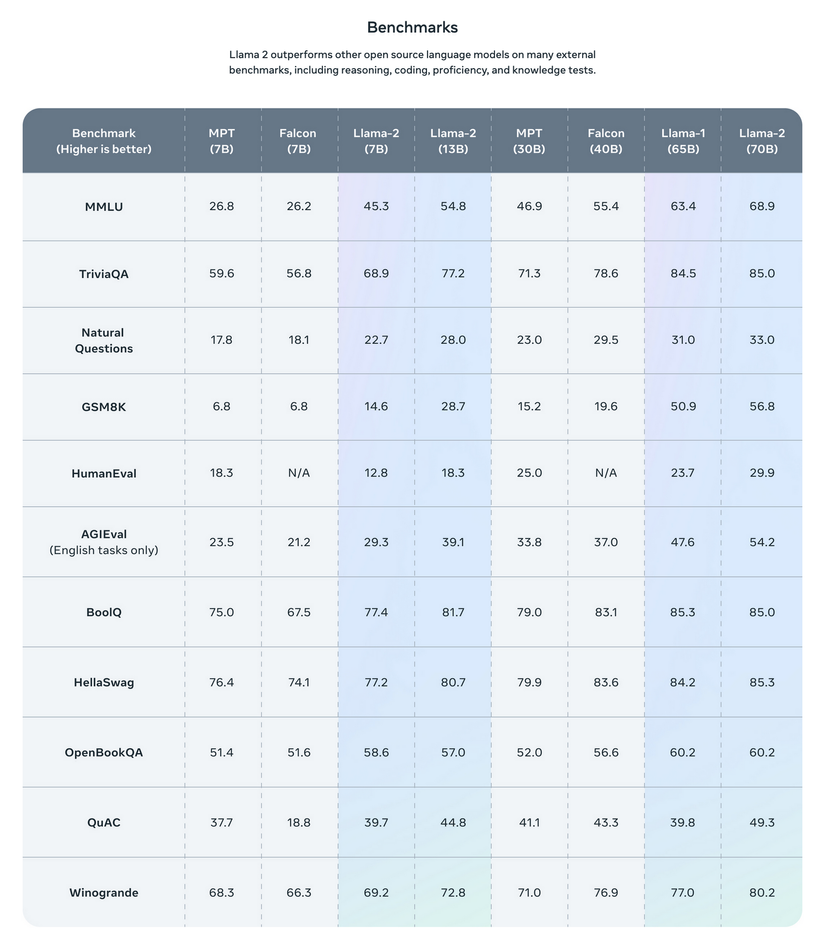
Kể từ thời điểm thế hệ đầu tiên ra mắt, Llama đã nhanh chóng tạo nên một cuộc cách mạng trong cộng đồng khoa học máy tính. Sự xuất hiện của phiên bản Llama-2 tiếp tục khẳng định vị thế dẫn đầu của Meta khi mang tới hàng loạt nâng cấp cốt lõi về quy mô dữ liệu và chiều dài xử lý ngữ cảnh. Với những ai đang tìm hiểu trí tuệ nhân tạo là gì, mô hình ngôn ngữ lớn như Llama chính là minh chứng trực quan nhất cho khả năng tự học sâu (Deep Learning) trên khối lượng văn bản khổng lồ từ Internet.
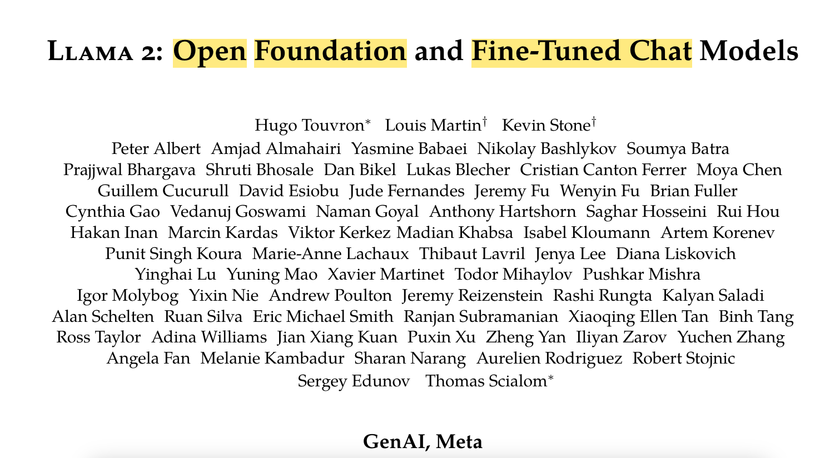
Đội ngũ nghiên cứu FAIR và GenAI thuộc Meta đứng sau công trình Llama-2.
So với thế hệ Llama-1 sơ khởi, Llama-2 sở hữu những nâng cấp kỹ thuật mang tính đột phá nhằm tăng cường độ chính xác và khả năng duy trì bối cảnh:
Độ dài ngữ cảnh (Context Length): Mở rộng gấp đôi từ 2.048 tokens lên 4.096 tokens, cho phép mô hình tiếp nhận tài liệu dài hơn và giữ tính mạch lạc qua nhiều lượt hội thoại phức tạp.
Dung lượng tập dữ liệu tiền huấn luyện: Tăng thêm 40%, đạt cột mốc 2 nghìn tỷ (2 trillion) tokens, giúp làm giàu vốn tri thức nền tảng và nâng cao tư duy logic.
Đa dạng kích thước mô hình: Phát hành với các phiên bản 7 tỷ (7B), 13 tỷ (13B) và 70 tỷ (70B) tham số, đáp ứng từ môi trường thử nghiệm biên (edge computing) cho đến hạ tầng phân tán cao cấp.
Cơ chế Grouped-Query Attention (GQA): Giảm thiểu tài nguyên bộ nhớ đệm (KV cache) trong quá trình suy luận (inference), hỗ trợ tăng tốc độ phản hồi đáng kể trên biến thể 70B.
Cơ chế Grouped-Query Attention (GQA) tối ưu hóa băng thông bộ nhớ suy luận so với Multi-Head Attention truyền thống.
Sự cải tiến của GQA với 8 cặp key-value projection giúp giải phóng áp lực băng thông bộ nhớ GPU – một trong những rào cản lớn nhất khi chạy mô hình ngôn ngữ trên các hệ thống vừa và nhỏ. Nhờ vậy, người dùng có thể trải nghiệm trực tiếp khả năng suy luận nhanh nhạy của mô hình qua các nền tảng thử nghiệm công cộng như Perplexity AI tại địa chỉ https://llama.perplexity.ai/ trước khi quyết định tự thiết lập phần cứng riêng.
Kiến trúc kỹ thuật Transformer và quy trình huấn luyện chuyên sâu của Llama
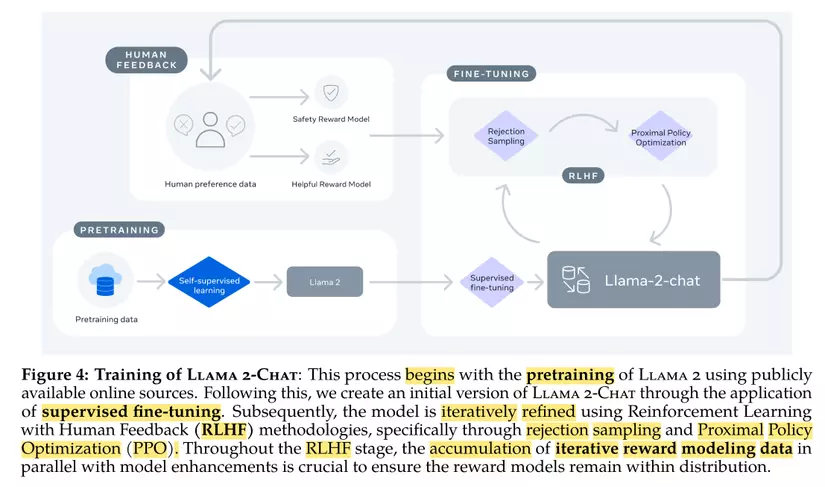
Về mặt kỹ thuật, Llama sử dụng kiến trúc mạng Transformer tự hồi quy (autoregressive Transformer) nhưng tích hợp ba cải tiến cấu trúc then chốt: chuẩn hóa RMSNorm ở mỗi lớp phụ, hàm kích hoạt SwiGLU phi tuyến và mã hóa vị trí xoay Rotary Positional Embeddings (RoPE). Quy trình hoàn thiện mô hình trải qua ba giai đoạn khắt khe: Pretraining quy mô lớn, Tinh chỉnh có giám sát (SFT) và Học tăng cường từ phản hồi của con người (RLHF).
Thay vì sử dụng lớp chuẩn hóa LayerNorm truyền thống, Llama áp dụng RMSNorm (Root Mean Square Normalization) nhằm đơn giản hóa phép tính nhưng vẫn đảm bảo tính ổn định gradient trong quá trình lan truyền ngược. Kết hợp với hàm kích hoạt SwiGLU – biến thể lai giữa Swish và Gated Linear Unit, mô hình cải thiện vượt bậc khả năng biểu diễn phi tuyến của các tầng mạng nơ-ron đa lớp. Đồng thời, cơ chế RoPE mã hóa vị trí theo phương pháp vector xoay giúp mô hình xử lý mối tương quan khoảng cách giữa các từ linh hoạt hơn nhiều so với positional encoding tĩnh.
Quy trình huấn luyện khép kín từ Pretraining, Supervised Fine-Tuning (SFT) đến RLHF lặp lại nhiều vòng.
Giai đoạn tiền huấn luyện (Pretraining) đòi hỏi nguồn tài nguyên tính toán khổng lồ. Meta đã huy động các cụm máy chủ trang bị GPU NVIDIA A100 tiêu chuẩn công nghiệp với tổng thời gian tính toán lên tới 3,3 triệu đến 3,4 triệu giờ GPU. Quá trình này giúp mô hình tiếp thu quy luật ngữ pháp, cấu trúc lập trình và tri thức tự nhiên từ hàng nghìn tỷ token văn bản công khai mà không cần gán nhãn thủ công.
Tiếp theo, giai đoạn Tinh chỉnh có giám sát (Supervised Fine-Tuning – SFT) tập trung vào việc định hướng mô hình trả lời theo phong cách trợ lý đàm thoại. Thay vì nhồi nhét hàng triệu bản ghi không chọn lọc, nhóm nghiên cứu nhận thấy việc sử dụng khoảng 27.540 mẫu hội thoại gán nhãn chất lượng cao mang lại kết quả vượt trội hơn hẳn so với dữ liệu rác số lượng lớn. Đây cũng là bí quyết giúp mô hình bắt nhịp gần hơn với chuẩn mực mà các trợ lý độc quyền như Chatgpt đã thiết lập.
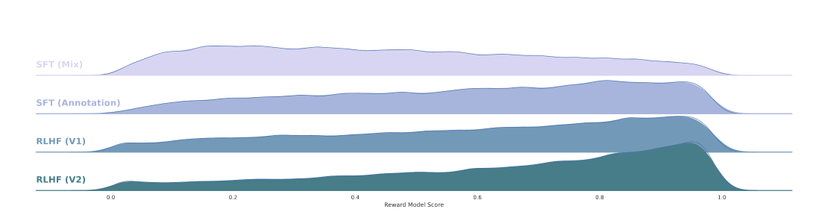
Sự dịch chuyển phân phối đầu ra của mô hình sau các vòng RLHF để tiệm cận tốt hơn với tiêu chuẩn đánh giá của con người.
Combo 5 cuốn : Chat GPT Thực Chiến + Chat GPT + Kỹ Thuật Đặt Câu Lệnh Cho Chat GPT + AI 5.0 + AI Công Cụ NCHSCV
Linh hồn của cơ chế RLHF: Kiến trúc Reward Modeling độc lập
Cơ chế Reward Modeling (Mô hình phần thưởng) được xem là “linh hồn” đưa phiên bản Llama-2-Chat tiệm cận năng lực của con người. Meta đã triển khai chiến lược tách rời hai Reward Model độc lập gồm mô hình Đánh giá tính hữu ích (Helpfulness) và mô hình Đánh giá tính an toàn (Safety), tránh xung đột mục tiêu trong quá trình tối ưu hóa chính sách phản hồi.
Việc dung hòa giữa câu trả lời đầy đủ thông tin và tính an toàn đạo đức luôn là bài toán nan giải trong phát triển AI. Nếu chỉ huấn luyện một bộ đánh giá chung, mô hình có xu hướng từ chối quá mức (over-refusal) đối với những câu hỏi nhạy cảm nhưng vô hại. Bằng cách chia tách thành hai mô hình phần thưởng riêng biệt, các nhà nghiên cứu có thể hiệu chỉnh hàm mục tiêu một cách trực giao: tối đa hóa giá trị phản hồi có ích nhưng vẫn kiểm soát nghiêm ngặt các rủi ro độc hại.
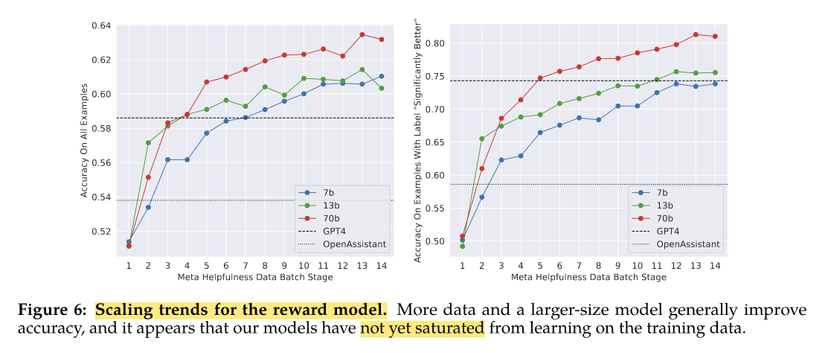
Độ chính xác của Reward Model tăng trưởng ổn định theo tuần dữ liệu, đạt xấp xỉ 90% ở các mẫu có sự chênh lệch chất lượng rõ rệt.
Bộ dữ liệu sở thích (preference data) của con người được Meta cập nhật liên tục hàng tuần theo phương thức cuốn chiếu (iterative batching). Dữ liệu phân loại theo thang điểm từ “Tốt hơn một chút” đến “Tốt hơn vượt trội” (Significantly Better). Kết quả thực nghiệm cho thấy:
Độ chính xác dự đoán tổng thể của Reward Model đạt từ 60% đến 70% đối với các trường hợp phản hồi có chất lượng tương đương.
Độ chính xác tăng vọt lên tới gần 90% khi hai câu trả lời có sự khác biệt rõ rệt về mặt nội dung logic hoặc mức độ tuân thủ tiêu chuẩn an toàn.
Song song với thuật toán PPO (Proximal Policy Optimization) kinh điển, Meta ứng dụng kỹ thuật Rejection Sampling Fine-Tuning. Hệ thống sẽ sinh ra hàng loạt câu trả lời từ mô hình chính sách hiện tại, sau đó Reward Model sẽ chấm điểm để chọn ra ứng viên đạt điểm cao nhất dùng làm dữ liệu fine-tune cho vòng lặp tiếp theo. Sự phối hợp nhịp nhàng giữa Rejection Sampling và PPO giúp đẩy giới hạn hiệu năng của Llama-2 vượt xa các mô hình mã nguồn mở cùng thời kỳ.
Đánh giá tính mở và các điều khoản thương mại đối với mô hình Llama
Mặc dù được Meta công bố rộng rãi dưới danh nghĩa “Open Source”, Llama trên thực tế thuộc nhóm mô hình cung cấp trọng số mở (Open Weights) đi kèm giấy phép thương mại có điều kiện, thay vì tuân thủ định nghĩa nguồn mở thuần túy theo tiêu chuẩn của Tổ chức Sáng kiến Nguồn Mở (OSI – Open Source Initiative).
Meta công khai mã nguồn kiến trúc và bộ trọng số tiền huấn luyện cũng như tinh chỉnh, hỗ trợ các nhà phát triển toàn quyền tải về máy chủ cục bộ. Tuy nhiên, mã nguồn huấn luyện gốc (training pipelines), bộ lọc dữ liệu thô và trọng số của các Reward Model không được công bố. Hơn thế nữa, điều khoản cấp phép của Meta áp đặt những quy định bắt buộc về mục đích sử dụng và phân phối.
Theo dõi liên tục các tin tức trí tuệ nhân tạo cho thấy tính mở này có kèm theo ràng buộc pháp lý cụ thể:
Rào cản quy mô người dùng: Bất kỳ sản phẩm, dịch vụ nào ứng dụng Llama mà có lượng người dùng hoạt động hàng tháng (Monthly Active Users – MAU) vượt quá 700 triệu người tại thời điểm phát hành đều phải nộp đơn xin cấp phép thương mại riêng từ Meta.
Chính sách sử dụng chấp nhận được (AUP): Nghiêm cấm sử dụng đầu ra của Llama để đào tạo hay cải thiện bất kỳ mô hình ngôn ngữ cạnh tranh nào khác, ngoại trừ việc phục vụ nghiên cứu nội bộ của chính người dùng.
Giới hạn lĩnh vực: Cấm triệt để việc khai thác mô hình trong các hoạt động vũ trang, phát tán thông tin sai lệch có tổ chức, hoặc can thiệp hạ tầng mạng quân sự.
Đối với đại đa số doanh nghiệp vừa và nhỏ, giấy phép này hoàn toàn thông thoáng và mở ra cơ hội thương mại hóa mạnh mẽ mà không tốn phí bản quyền. Tuy nhiên, với các tập đoàn công nghệ quy mô khổng lồ, việc phụ thuộc vào Llama đòi hỏi quá trình rà soát pháp lý nghiêm ngặt nhằm tránh các tranh chấp về quyền sở hữu trí tuệ sau này.
Chi phí thực tế và giải pháp self-host Llama cho doanh nghiệp
Việc tự triển khai (self-host) Llama trên hạ tầng phần cứng nội bộ giải quyết triệt để vấn đề rò rỉ dữ liệu nhạy cảm, song đòi hỏi doanh nghiệp phải đầu tư chi phí máy chủ và có kế hoạch tối ưu tài nguyên suy luận bài bản.
Để đạt được thành quả Llama-2 hoàn chỉnh, Meta đã đầu tư nguồn lực khổng lồ mà hiếm doanh nghiệp nào có thể tự gánh vác: chi phí gán nhãn dữ liệu con người ước tính xấp xỉ 8 triệu USD, tiêu thụ hơn 1,3 triệu kWh điện và phát thải tương đương 539 tấn CO2 trong suốt quá trình vận hành hạ tầng máy chủ AI. Do đó, việc tận dụng mô hình nền tảng có sẵn và chỉ tập trung vào hạ tầng suy luận cục bộ là con đường kinh tế nhất hiện nay.
Kích thước mô hình
VRAM tối thiểu (FP16)
VRAM sau khi Quantize (4-bit/8-bit)
Cấu hình phần cứng đề xuất
Llama 7B
~14 GB – 16 GB
~6 GB – 8 GB
1x NVIDIA RTX 3060 (12GB) hoặc RTX 4060 Ti (16GB)
Llama 13B
~26 GB – 28 GB
~10 GB – 14 GB
1x NVIDIA RTX 3090 / 4090 (24GB)
Llama 70B
~140 GB+
~38 GB – 48 GB
2x NVIDIA RTX 4090 (NVLink/PCIe) hoặc cụm 2x-4x A5000/A6000
Để tối ưu hóa chi phí hạ tầng, các kỹ sư hệ thống thường áp dụng các kỹ thuật lượng tử hóa (Quantization) như AWQ hoặc GPTQ nhằm đưa độ chính xác số học từ dạng số thực 16-bit (FP16) xuống dạng số nguyên 4-bit hoặc 8-bit mà không làm suy giảm đáng kể năng lực suy luận. Nhờ đó, một mô hình 70B phức tạp có thể chạy trơn tru trên 2 card đồ họa chuyên dụng thông thường thay vì phải thuê cụm GPU máy chủ đắt đỏ.
Bên cạnh phần cứng, việc lựa chọn phần mềm phục vụ suy luận đóng vai trò tối quan trọng. Các công cụ như vLLM với thuật toán PagedAttention, TensorRT-LLM của NVIDIA hay nền tảng quản trị gọn nhẹ Ollama giúp doanh nghiệp khai thác tối đa công suất máy chủ, giảm độ trễ (latency) khi có hàng trăm yêu cầu đồng thời. Đối với các đơn vị muốn xây dựng hệ thống phần cứng bền bỉ, tìm kiếm giải pháp linh kiện và thiết bị ngoại vi chuyên dụng tại Vietgear sẽ mang lại nền tảng vững chắc để thiết lập các trạm làm việc (Workstation) AI cục bộ ổn định và hiệu quả.
Đỗ Hoàng Lân là một doanh nhân, người sáng tạo số, digital marketing khởi nghiệp từ năm 2016 trong nhiều mảng cung cấp sản phẩm và dịch vụ, xây dựng và phát triển thương hiệu thông qua môi trường internet.