Quantization LLM là kỹ thuật nén mô hình cốt lõi giúp các hệ thống trí tuệ nhân tạo quy mô lớn có thể hoạt động mượt mà trên phần cứng hạn chế mà không làm suy giảm nghiêm trọng độ chính xác. Bằng cách giảm độ chính xác số học của các trọng số từ định dạng dấu phẩy động xuống số nguyên dung lượng thấp hơn, phương pháp này mở đường cho làn sóng triển khai Local AI hiệu quả và tiết kiệm chi phí.
Quantization LLM là gì và tại sao lại quan trọng trong Local AI?
Quantization LLM (lượng tử hóa mô hình ngôn ngữ lớn) là quy trình chuyển đổi độ chính xác số học của các tham số (parameters) trong mạng nơ-ron từ định dạng số thực dấu phẩy động 16-bit hoặc 32-bit (FP16, FP32) sang các định dạng số nguyên có số bit thấp hơn như INT8 hoặc INT4. Kỹ thuật này giúp cắt giảm đáng kể dung lượng bộ nhớ cần thiết để lưu trữ và vận hành mô hình.
Kích thước của một mô hình ngôn ngữ lớn được xác định bởi hàng tỷ trọng số được tối ưu hóa trong quá trình huấn luyện ban đầu. Khi đưa vào suy luận thực tế (inference), việc tải hàng tỷ tham số 16-bit vào bộ nhớ đồ họa (VRAM) đòi hỏi phần cứng cấp doanh nghiệp đắt đỏ. Đối với những ai đang tìm hiểu trí tuệ nhân tạo là gì và muốn tự triển khai các mô hình mã nguồn mở trên máy tính cá nhân, rào cản phần cứng luôn là thách thức lớn nhất.
Kỹ thuật lượng tử hóa giải quyết triệt để nút thắt cổ chai này bằng cách thu nhỏ kích thước tệp mô hình từ 2 đến 4 lần. Nhờ đó, các mô hình mạnh mẽ như Llama 3 8B hay 70B hoàn toàn có thể vận hành ổn định trên các GPU tiêu dùng hoặc chip tích hợp RAM thống nhất của máy tính cá nhân thay vì phụ thuộc hoàn toàn vào hệ thống đám mây.
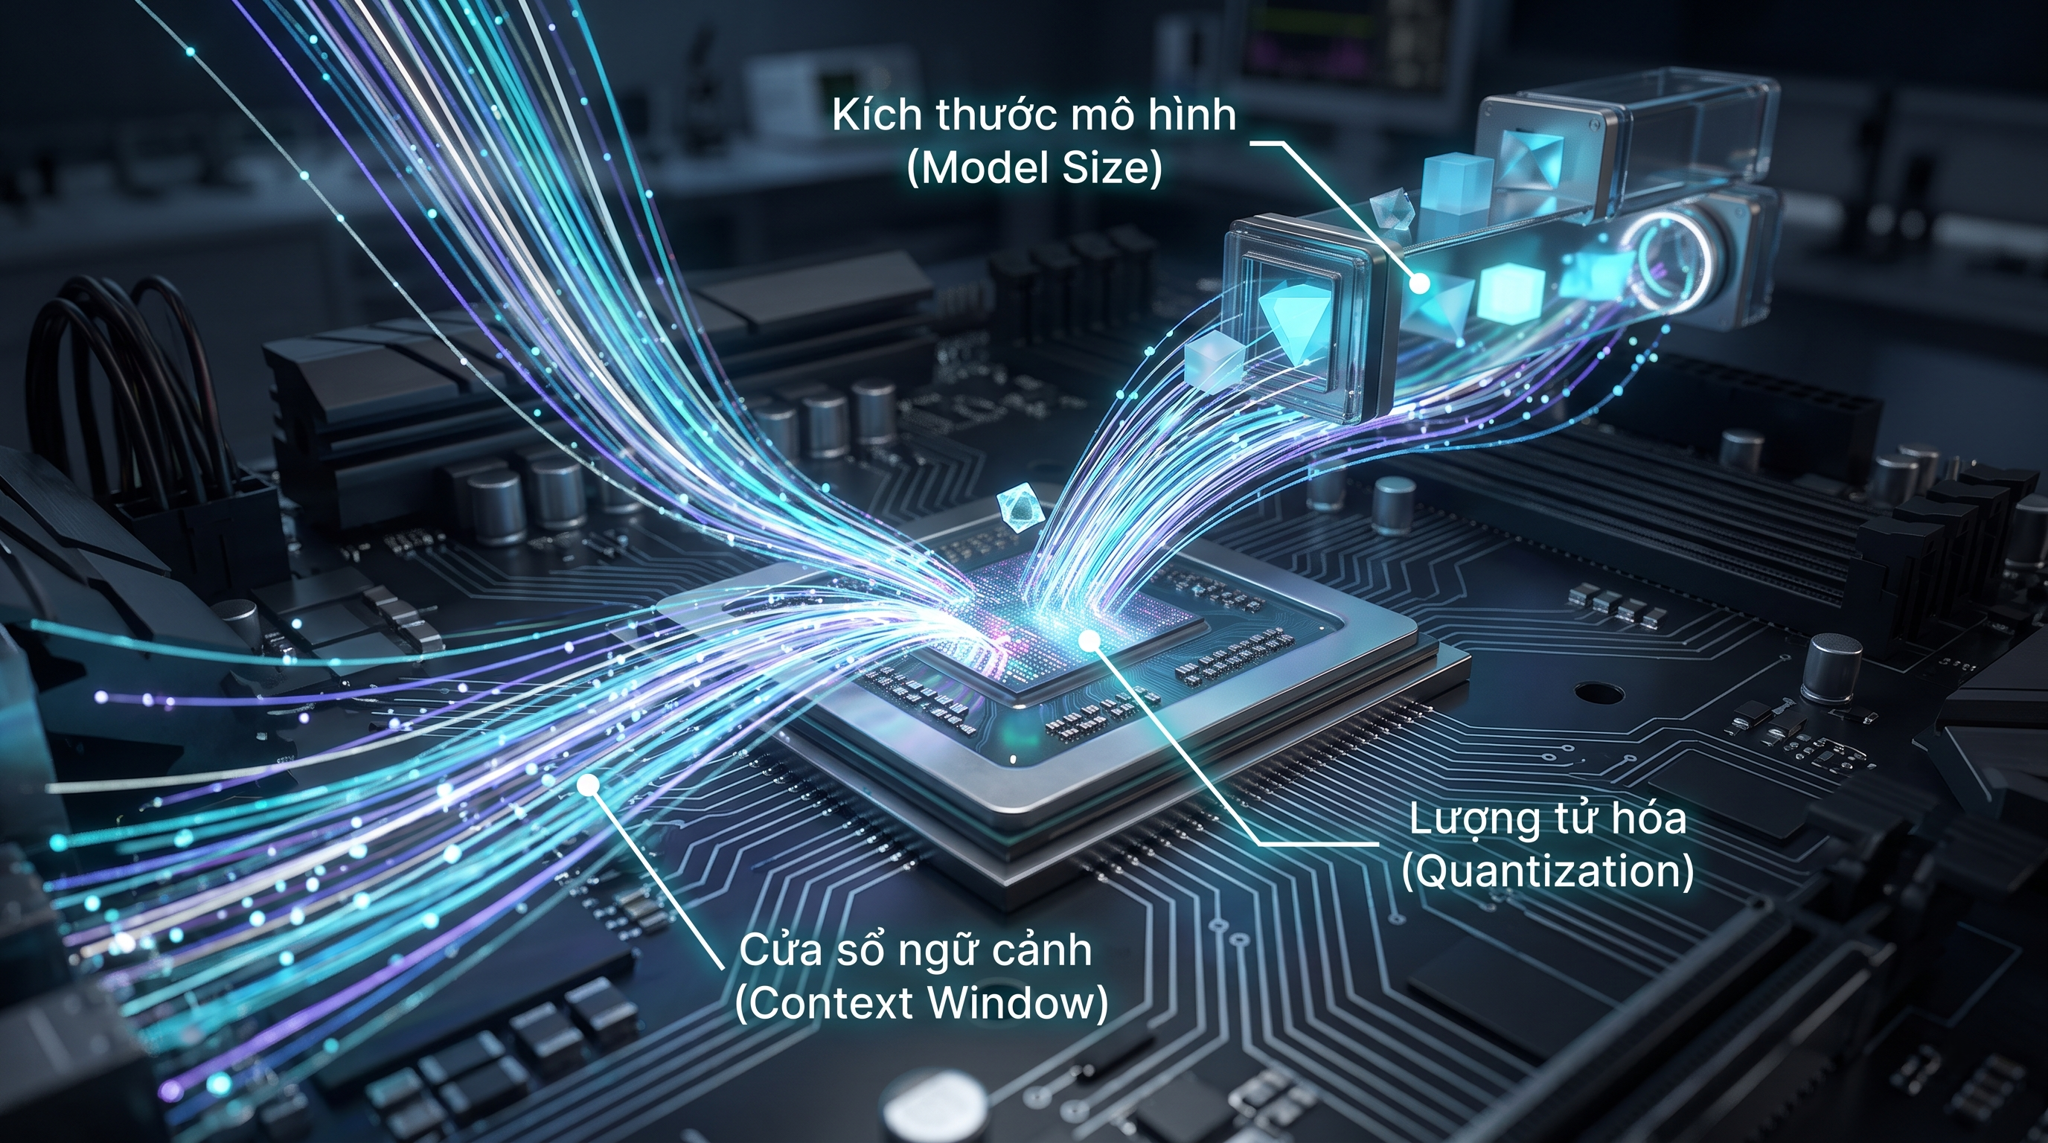
Sơ đồ minh họa mối quan hệ giữa Model Size, Quantization và Context Window trong Local AI
Cơ chế hoạt động và các mức độ Quantization phổ biến
Cơ chế vận hành của quantization dựa trên việc ánh xạ các giá trị liên tục trong dải số thực sang một tập hợp hữu hạn các giá trị số nguyên rời rạc thông qua các hệ số tỷ lệ (scaling factors). Dù một phần dữ liệu chi tiết ở phần thập phân bị lược bỏ, cấu trúc phân phối trọng số tổng thể vẫn được bảo toàn để giữ vững khả năng suy luận logic của hệ thống AI.
Hiện nay, cộng đồng công nghệ thường xuyên cập nhật qua các kênh tin tức trí tuệ nhân tạo về những định dạng lượng tử hóa tiên tiến, phục vụ cho các môi trường thực thi khác nhau:
FP16 / BF16 (16-bit Float): Định dạng nguyên bản sau khi huấn luyện, cho độ chính xác cao nhất nhưng ngốn nhiều VRAM nhất (mỗi tham số chiếm 2 byte bộ nhớ).
INT8 (8-bit Integer): Giảm kích thước mô hình xuống 50% so với FP16, bảo tồn gần như nguyên vẹn độ chuẩn xác (perplexity loss không đáng kể), là tiêu chuẩn lý tưởng cho môi trường máy chủ sản xuất.
INT4 (4-bit Integer): Giảm dung lượng mô hình tới 70-75%, cho phép chạy các mô hình 7B hoặc 8B chỉ với khoảng 5GB đến 6GB VRAM. Đây là mức nén phổ biến nhất trong cộng đồng người dùng tự triển khai mô hình.
Chuẩn định dạng thực thi:
GGUF: Chuẩn định dạng tối ưu cho suy luận trên CPU hoặc phân bổ giữa CPU và GPU, cực kỳ tối ưu cho các phần mềm như Ollama hay LM Studio.
GPTQ và AWQ: Chuẩn lượng tử hóa 4-bit chuyên dụng cho GPU Nvidia, tối ưu hóa thông lượng và tốc độ tạo token trên mỗi giây (tokens/sec).
EXL2: Định dạng nén tùy biến linh hoạt số bit cho mỗi lớp mạng, tối ưu riêng cho thư viện ExLlamaV2 trên GPU cao cấp.
Sự suy hao độ chính xác (perplexity loss) khi chuyển từ FP16 xuống INT8 thường ở mức dưới 1%, trong khi INT4 có thể gây ra sai số nhỏ tùy thuộc vào độ phức tạp của tác vụ. Tuy nhiên, mức độ tiết kiệm phần cứng vượt trội đã biến INT4 thành giải pháp tiêu chuẩn cho hầu hết các bài toán xử lý ngôn ngữ thông thường.
Combo 5 cuốn : Chat GPT Thực Chiến + Chat GPT + Kỹ Thuật Đặt Câu Lệnh Cho Chat GPT + AI 5.0 + AI Công Cụ NCHSCV
Mối quan hệ tương quan giữa Quantization, Model Size và Context Window
Vận hành một hệ thống suy luận AI không chỉ phụ thuộc vào dung lượng tệp mô hình mà là sự cộng hưởng giữa ba yếu tố cốt lõi: kích thước mô hình (Model Size), mức độ lượng tử hóa (Quantization) và cửa sổ ngữ cảnh (Context Window). Bỏ qua một trong ba yếu tố này thường dẫn đến hiện tượng tràn bộ nhớ (Out-of-Memory – OOM).
Một nguyên lý quan trọng được ghi nhận trong cộng đồng mã nguồn mở là: một mô hình kích thước lớn được lượng tử hóa sâu (ví dụ mô hình 70B nén xuống 4-bit) thường cho kết quả lập luận thông minh hơn một mô hình kích thước nhỏ giữ nguyên độ chính xác cao (ví dụ mô hình 8B ở chuẩn FP16). Lý do là vì số lượng tham số khổng lồ chứa đựng nhiều không gian tri thức tiềm ẩn hơn, dù độ phân giải số học của từng trọng số bị rút gọn.
Tuy nhiên, người dùng cần cảnh giác khi thực hiện nén cực đoan xuống mức 2-bit hoặc 3-bit. Khi đó, tỷ lệ suy giảm chất lượng tăng vọt, khiến mô hình dễ gặp hiện tượng ảo giác (hallucination hoặc confabulation), lặp từ ngữ hoặc mất khả năng suy luận logic chặt chẽ trong các tác vụ lập trình và toán học.
Ngoài ra, cửa sổ ngữ cảnh (Context Window) lớn làm tăng đột biến lượng tính toán và dung lượng của bộ nhớ đệm KV (Key-Value cache). Bộ nhớ đệm KV lưu giữ các trạng thái chú ý của các token trước đó trong đoạn hội thoại. Nếu người dùng nạp một đoạn văn bản dài hàng chục nghìn token tương tự các phiên làm việc nâng cao trên Chatgpt, dung lượng KV Cache có thể ngốn từ vài GB đến hàng chục GB VRAM, nhanh chóng vượt quá sức chứa của bộ nhớ đồ họa cá nhân dù bản thân mô hình đã được nén rất nhỏ.
Tiêu chí và chiến lược chọn mức Quantization tối ưu cho người mới
Để thiết lập môi trường Local AI vận hành trơn tru, người dùng cần tính toán dung lượng VRAM thực tế dựa trên công thức tổng hòa: Dung lượng cần thiết = Dung lượng mô hình nén + Bộ nhớ KV Cache + Bộ đệm ứng dụng (khoảng 1-2GB). Tránh việc tải mô hình vừa khít với tổng dung lượng VRAM của card đồ họa vì hệ điều hành sẽ gặp lỗi ngay khi bối cảnh hội thoại kéo dài.
Dưới đây là bảng tham chiếu nhanh giúp lựa chọn định dạng theo phần cứng cá nhân được các kỹ thuật viên phần cứng tại Vietgear khuyến nghị khi xây dựng cấu hình máy tính chạy AI:
Cấu hình phần cứng
Kích thước mô hình đề xuất
Mức Quantization lý tưởng
Định dạng tệp tối ưu
GPU 8GB VRAM (RTX 3060, RTX 4060)
7B – 8B tham số
Q4_K_M (4-bit)
GGUF hoặc AWQ
GPU 16GB VRAM (RTX 4080, T4)
7B – 8B / 14B tham số
Q8_0 (8-bit) cho 8B hoặc Q4 cho 14B
EXL2, GPTQ, GGUF
GPU 24GB VRAM (RTX 3090, RTX 4090)
14B – 32B tham số
Q4_K_M hoặc Q5_K_M
EXL2, AWQ, GGUF
Apple Silicon (16GB – 36GB Unified RAM)
8B – 14B tham số
Q4_K_M đến Q8_0
GGUF (tận dụng Metal)
Đối với người mới bắt đầu làm quen với mô hình ngôn ngữ tự triển khai, lộ trình an toàn nhất là bắt đầu với các mô hình 8B ở định dạng GGUF mức nén 4-bit (chẳng hạn như chuẩn Q4_K_M). Mức cấu hình này mang lại sự cân bằng hoàn hảo giữa tốc độ phản hồi nhanh, chất lượng lập luận tự nhiên và khả năng tương thích cao trên hầu hết các dòng máy tính phổ thông hiện nay.
Nếu nhu cầu công việc đòi hỏi xử lý tài liệu chuyên sâu mà mô hình nhỏ nén 4-bit chưa thể ghi nhớ toàn bộ kho tri thức, giải pháp tối ưu là kết hợp kỹ thuật RAG (Retrieval-Augmented Generation). Việc tích hợp cơ sở dữ liệu vector bên ngoài sẽ bù đắp hoàn toàn những thiếu hụt về mặt tri thức chuyên ngành, giúp bạn tận dụng trọn vẹn sức mạnh của các mô hình đã lượng tử hóa mà không cần đầu tư các cụm phần cứng đắt đỏ.
Đỗ Hoàng Lân là một doanh nhân, người sáng tạo số, digital marketing khởi nghiệp từ năm 2016 trong nhiều mảng cung cấp sản phẩm và dịch vụ, xây dựng và phát triển thương hiệu thông qua môi trường internet.