Vector database là gì trong RAG là câu hỏi cốt lõi đối với các kỹ sư khi xây dựng hệ thống trí tuệ nhân tạo hiện đại nhằm giải quyết bài toán ảo giác (hallucination) của các mô hình ngôn ngữ lớn. Công nghệ này đóng vai trò như một bộ nhớ ngữ nghĩa dài hạn, cho phép truy xuất chính xác thông tin chuyên biệt trước khi đưa vào mô hình sinh văn bản. Hiểu đúng bản chất của cơ sở dữ liệu vector cùng quy trình vận hành thực tế sẽ giúp bạn làm chủ kiến trúc RAG thay vì phụ thuộc vào các cấu hình mặc định kém hiệu quả.
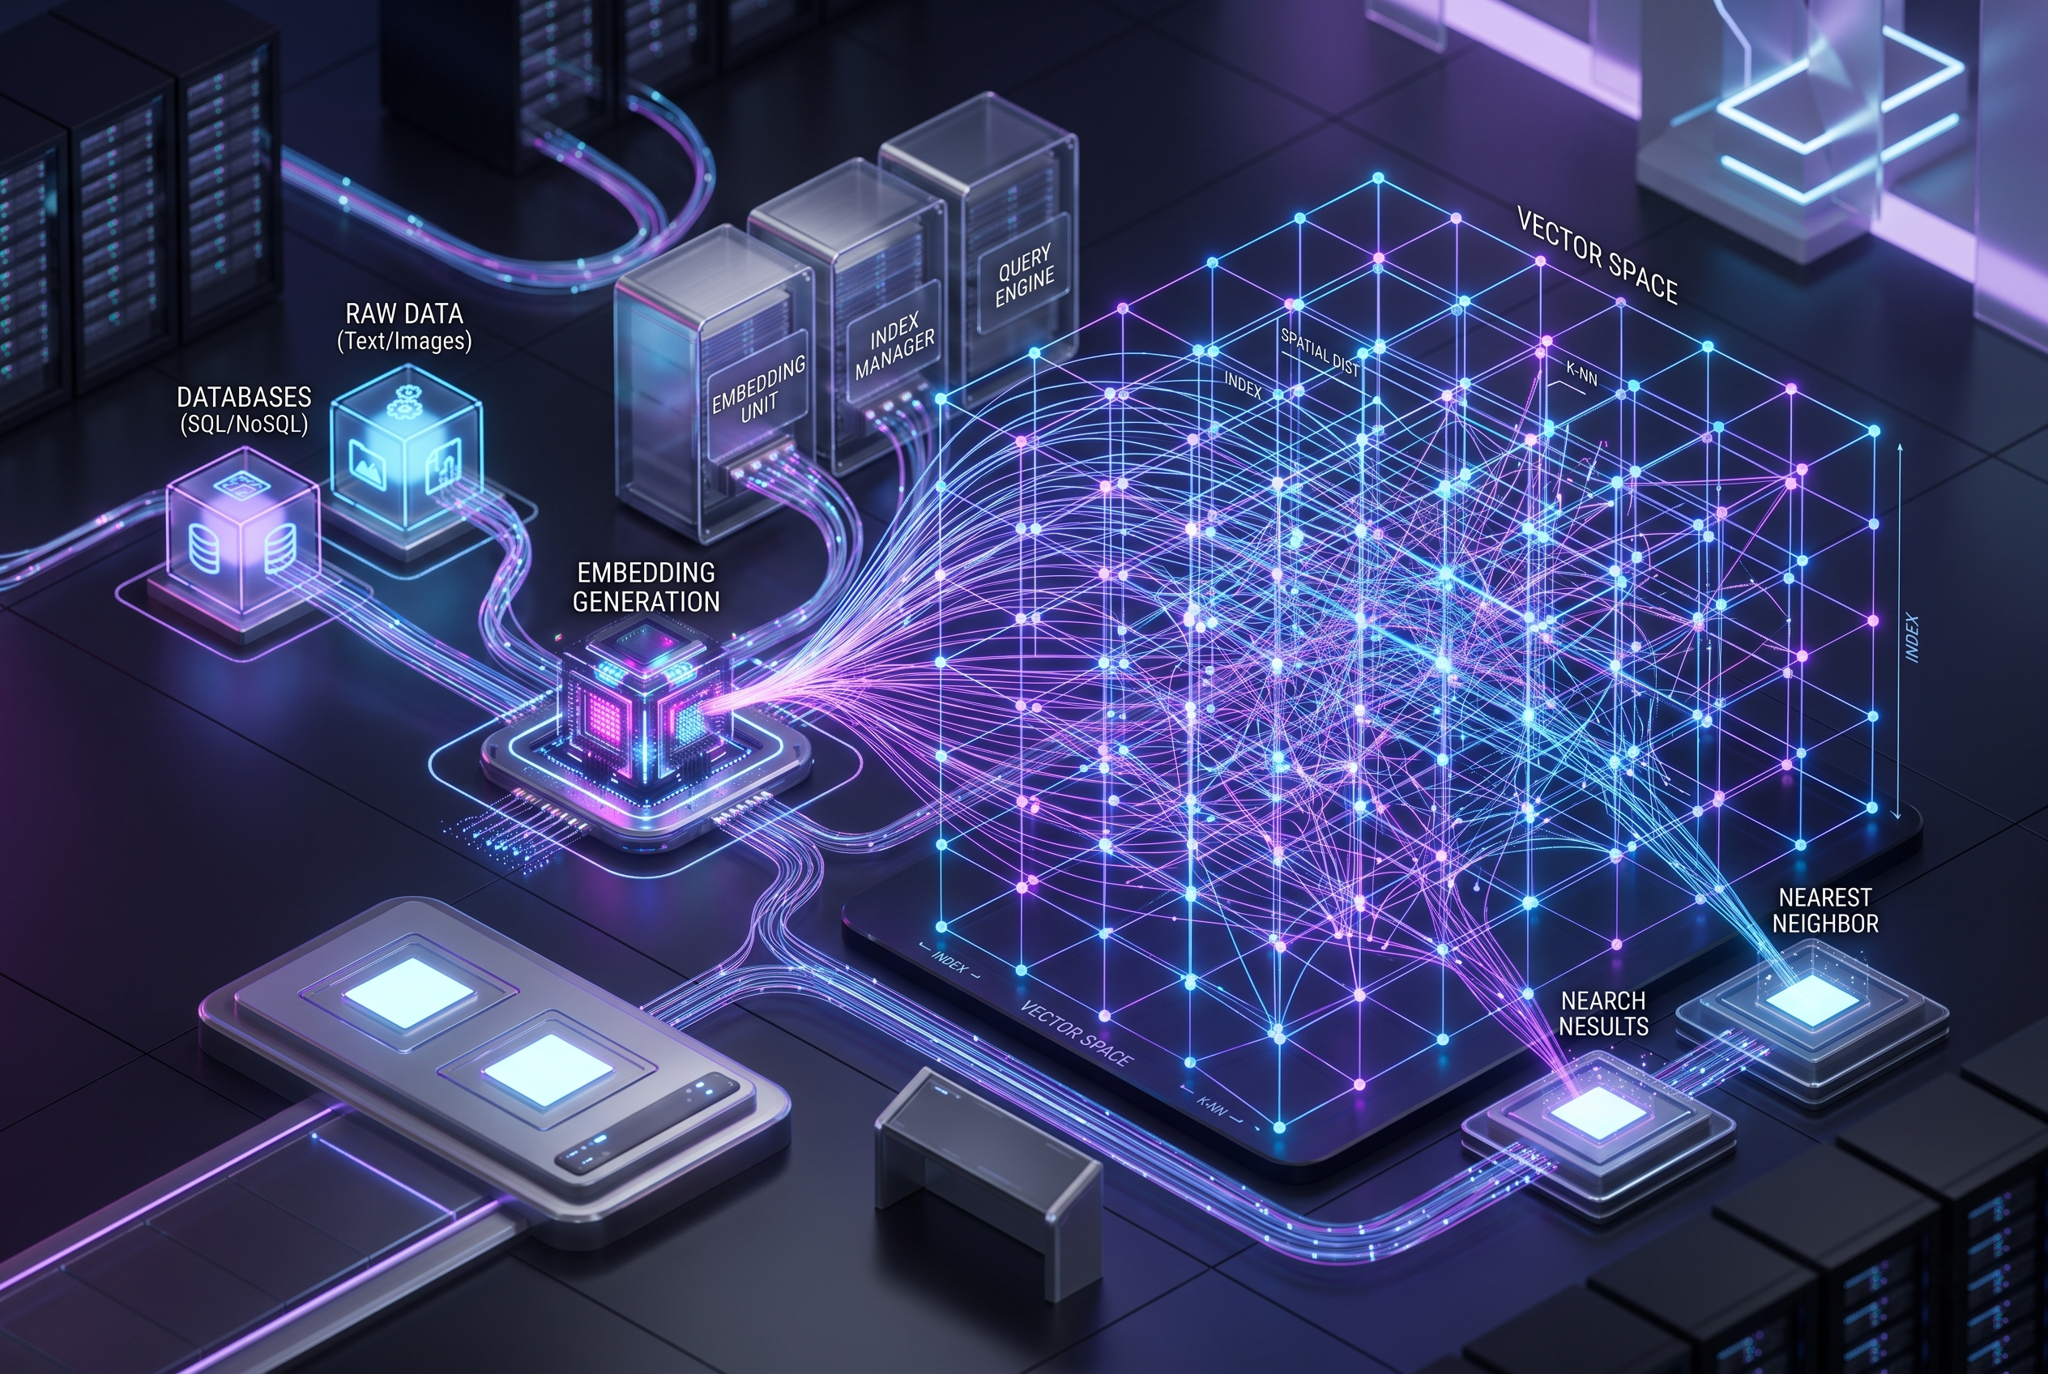
Sơ đồ quy trình chuẩn bị dữ liệu và retrieval trước khi sinh câu trả lời trong RAG
Bản chất vector database là gì trong RAG và vai trò kiến trúc
Vector database trong hệ thống RAG là cơ sở dữ liệu chuyên biệt dùng để lưu trữ, lập chỉ mục và truy xuất các vector đặc trưng (embeddings) nhằm xác định ngữ cảnh tài liệu tương đồng nhất về mặt ngữ nghĩa với truy vấn đầu vào.
Để hiểu rõ khái niệm này, trước hết cần nắm bắt trí tuệ nhân tạo là gì trong bối cảnh xử lý ngôn ngữ tự nhiên. Khi xây dựng các ứng dụng mở rộng từ mô hình nền tảng, văn bản phi cấu trúc cần được chuyển đổi thành các chuỗi số đa chiều thông qua mô hình nhúng (embedding model). Vector database chịu trách nhiệm quản lý hàng triệu biểu diễn toán học này, cho phép tính toán khoảng cách ngữ nghĩa bằng các thuật toán như Cosine Similarity, Dot Product hoặc Euclidean Distance với tốc độ miligiây.
Trong kiến trúc RAG (Retrieval-Augmented Generation), cơ sở dữ liệu vector giữ vai trò cung cấp tri thức nền (grounding source) từ kho dữ liệu riêng của tổ chức. Thay vì phải tái huấn luyện toàn bộ mạng nơ-ron tốn kém, hệ thống chỉ cần tìm kiếm các đoạn văn bản liên quan trực tiếp đến câu hỏi của người dùng và chuyển giao cho mô hình ngôn ngữ xử lý tiếp.
Tuy nhiên, một ngộ nhận phổ biến là việc tích hợp cơ sở dữ liệu vector sẽ tự động giúp hệ thống luôn phản hồi đúng. Thực tế, vector database chỉ đơn thuần tìm kiếm dữ liệu tương đồng về mặt toán học. Nếu dữ liệu đầu vào chứa nhiều nhiễu, không có siêu dữ liệu (metadata) hỗ trợ hoặc chiến lược lập chỉ mục lỏng lẻo, kết quả trả về vẫn sẽ dẫn đến hiện tượng hallucination trong mô hình sinh câu trả lời.
Quy trình vận hành phối hợp giữa Vector Database và RAG
Quy trình vận hành của vector database trong RAG được cấu trúc thành ba giai đoạn độc lập nhưng liên kết chặt chẽ: Nạp dữ liệu (Ingestion), Truy xuất (Retrieval) và Mở rộng ngữ cảnh để sinh phản hồi (Generation).
Giai đoạn nạp dữ liệu bắt đầu bằng việc thu thập tài liệu từ nhiều định dạng khác nhau như PDF, trang tính, tài liệu nội bộ hay API. Toàn bộ kho nội dung này sẽ được làm sạch, chia nhỏ thành các đoạn văn ngắn (chunks), sau đó đưa qua mô hình embedding để biến đổi thành các vector tương ứng. Từng vector sẽ được lưu trữ kèm theo metadata (như tác giả, thời gian tạo, phân quyền thư mục) bên trong cơ sở dữ liệu vector.
Khi người dùng gửi một yêu cầu, quy trình RAG thực thi theo ba bước kỹ thuật rõ ràng:
Retrieval (Truy xuất): Câu hỏi của người dùng được mô hình embedding mã hóa thành một vector truy vấn. Vector database tiến hành quét chỉ mục để tìm kiếm các đoạn tài liệu có khoảng cách vector gần nhất.
Augment (Tăng cường): Các đoạn dữ liệu liên quan được trích xuất, kết hợp cùng câu hỏi gốc và chỉ thị nghiệp vụ (system prompt) để tạo thành một khối ngữ cảnh hoàn chỉnh.
Generate (Sinh nội dung): Toàn bộ gói ngữ cảnh được gửi đến các mô hình tiên tiến như Chatgpt để xử lý suy luận và tạo ra văn bản trả lời tự nhiên, có căn cứ rõ ràng từ dữ liệu đã truy xuất.
Việc phân tách rõ ràng giữa lớp truy xuất và lớp sinh câu trả lời cho phép các kỹ sư tối ưu hóa độ chính xác của hệ thống một cách có hệ thống, thay vì chỉ tinh chỉnh câu lệnh prompt một cách cảm tính.
Combo 5 cuốn : Chat GPT Thực Chiến + Chat GPT + Kỹ Thuật Đặt Câu Lệnh Cho Chat GPT + AI 5.0 + AI Công Cụ NCHSCV
Chiến lược tối ưu hóa Chunking, Metadata và Reranking
Hiệu quả của tầng truy xuất trong RAG không phụ thuộc vào các thông số cấu hình mặc định mà đòi hỏi kỹ sư phải điều chỉnh linh hoạt theo đặc thù tài liệu và nghiệp vụ thực tế.
Tổ chức kích thước chunk dựa trên cấu trúc tài liệu
Sai lầm thường gặp nhất khi triển khai RAG là áp dụng một kích thước chunk cố định (chẳng hạn 512 tokens) cho toàn bộ tập dữ liệu. Cách tiếp cận này phá vỡ tính toàn vẹn của ngữ cảnh, khiến các đoạn thông tin quan trọng bị cắt ngang giữa chừng.
Phương pháp tối ưu là phân đoạn dữ liệu theo cấu trúc tự nhiên của văn bản, bao gồm tiêu đề, đề mục con, bảng biểu hoặc ranh giới ngữ nghĩa của từng đoạn văn. Kích thước chunk cần đủ nhỏ để giữ độ tập trung cho vector embedding, nhưng cũng phải đủ lớn để mô hình ngôn ngữ hiểu được bối cảnh nội dung.
Lọc nâng cao bằng Metadata và Hybrid Search
Tìm kiếm vector đơn thuần dựa vào ngữ nghĩa đôi khi bỏ sót các thuật ngữ chuyên môn, mã sản phẩm hoặc tên riêng viết tắt. Do đó, việc kết hợp giữa tìm kiếm từ khóa truyền thống (Lexical Search như BM25) và tìm kiếm ngữ nghĩa (Vector Search) thông qua kỹ thuật Hybrid Search là tiêu chuẩn bắt buộc cho các hệ thống thương mại.
Song song với đó, việc khai thác metadata cho phép hệ thống áp dụng các bộ lọc cứng (pre-filtering) trước khi tính toán độ tương đồng. Nhờ vậy, truy vấn có thể giới hạn phạm vi tài liệu theo phòng ban, thời gian hiệu lực hoặc quyền hạn truy cập của người dùng một cách chặt chẽ.
Áp dụng Reranking để tinh gọn ngữ cảnh
Sau khi tầng retrieval chọn ra khoảng 20-50 ứng viên tiềm năng, việc đưa toàn bộ lượng văn bản này vào prompt sẽ làm loãng thông tin và tăng chi phí token. Lúc này, một mô hình Reranker (như Cross-Encoder) được sử dụng để chấm điểm và sắp xếp lại mức độ liên quan trực tiếp giữa câu hỏi và từng đoạn văn bản.
Reranking giúp chọn lọc ra 3-5 đoạn thông tin có chất lượng cao nhất để đưa vào mô hình sinh câu trả lời, từ đó cải thiện đáng kể độ chính xác của phản hồi cuối cùng.
Phương pháp đánh giá độc lập tầng Retrieval trong RAG
Đánh giá chất lượng của tầng truy xuất dữ liệu cần được tách rời khỏi tầng sinh văn bản để xác định chính xác điểm nghẽn của toàn bộ hệ thống.
Khi một hệ thống RAG đưa ra câu trả lời sai, nguyên nhân có thể do vector database không lấy đúng thông tin (Retrieval Failure) hoặc do mô hình ngôn ngữ đọc hiểu sai ngữ cảnh được cung cấp (Generation Failure). Nếu chỉ đánh giá kết quả đầu ra chung cuộc, nhà phát triển sẽ không thể biết cần tinh chỉnh chỉ mục vector hay sửa đổi prompt.
Theo dõi các nguồn tin tức trí tuệ nhân tạo và tài liệu kỹ thuật chuyên sâu, quy trình đánh giá retrieval chuẩn mực cần tuân thủ các bước kiểm thử cụ thể sau:
Xây dựng Query Set có nhãn (Ground Truth): Tập hợp danh sách các câu hỏi phổ biến kèm vị trí chính xác của đoạn tài liệu chứa câu trả lời cần tìm.
Đo lường các chỉ số truy xuất cốt lõi: Tính toán độ chính xác bằng các phép đo kỹ thuật như Hit Rate, Recall@K, và Mean Reciprocal Rank (MRR) để xem văn bản đúng có nằm trong top kết quả trả về hay không.
Phân loại lỗi theo nhóm tài liệu: Ghi nhận tỷ lệ truy xuất thất bại theo từng định dạng (văn bản text, bảng biểu số liệu, văn bản quét OCR) nhằm tìm ra điểm yếu trong khâu tiền xử lý dữ liệu.
Kiểm định Citation và Fallback: Đảm bảo hệ thống trích dẫn đúng vị trí nguồn (locator) của tài liệu và kích hoạt cơ chế thông báo “không tìm thấy dữ liệu” thay vì cố tình suy đoán khi ngữ cảnh không đủ căn cứ.
Chỉ khi tầng truy xuất đạt được tỷ lệ bao phủ và độ chính xác cao trên tập dữ liệu chuẩn, kỹ sư mới nên chuyển sang tối ưu hóa các tham số sinh câu trả lời của mô hình ngôn ngữ lớn.
Hạ tầng phần cứng và bảo mật khi vận hành Vector Database
Quy mô dữ liệu và khối lượng công việc tính toán vector đặt ra những yêu cầu khắt khe về cấu hình phần cứng cũng như cơ chế phân quyền bảo mật của toàn hệ thống.
Hạ tầng phần cứng PC AI cho workload phát triển AI
Trong quá trình thử nghiệm cục bộ (local development) hoặc vận hành on-premise, việc xử lý hàng triệu embedding đòi hỏi tài nguyên tính toán đáng kể. Các máy trạm phục vụ AI cần được trang bị bộ vi xử lý đa nhân, dung lượng RAM lớn để lưu trữ chỉ mục trong bộ nhớ (HNSW index) cùng card đồ họa có VRAM đủ lớn nhằm tăng tốc quá trình embedding tài liệu. Đội ngũ kỹ sư tại Vietgear thường xuyên nhấn mạnh tầm quan trọng của việc cân đối phần cứng với tải trọng tính toán thực tế để tránh hiện tượng nghẽn cổ chai trong quá trình lập chỉ mục.
Bên cạnh yếu tố hạ tầng, bảo mật quyền truy cập (Authorization) là rào cản lớn khi đưa RAG vào môi trường doanh nghiệp. Bản thân vector database không thể tự động nhận biết người dùng nào có quyền xem tài liệu nào nếu không có sự can thiệp kiến trúc. Mọi đoạn dữ liệu được lập chỉ mục phải gắn liền với danh sách kiểm soát quyền truy cập (Access Control List – ACL), đảm bảo chỉ những tài liệu mà người dùng có quyền hạn mới được đưa vào quá trình tìm kiếm ngữ cảnh.
Đặc biệt khi tích hợp RAG vào các hệ thống AI Agent có khả năng tự động thực thi tác vụ, nguyên tắc đặc quyền tối thiểu (Least Privilege) và sự giám sát của con người (Human-in-the-loop) cần được duy trì nghiêm ngặt để ngăn ngừa rò rỉ dữ liệu hoặc sai lệch hành vi trên diện rộng.
Tóm lại, vector database là nền tảng cốt lõi định hình độ chuẩn xác của kiến trúc RAG, nhưng hiệu năng thực sự chỉ đến từ sự phối hợp hài hòa giữa chiến lược tiền xử lý văn bản, thuật toán truy xuất kết hợp và quy trình kiểm thử nghiêm ngặt.
Đỗ Hoàng Lân là một doanh nhân, người sáng tạo số, digital marketing khởi nghiệp từ năm 2016 trong nhiều mảng cung cấp sản phẩm và dịch vụ, xây dựng và phát triển thương hiệu thông qua môi trường internet.